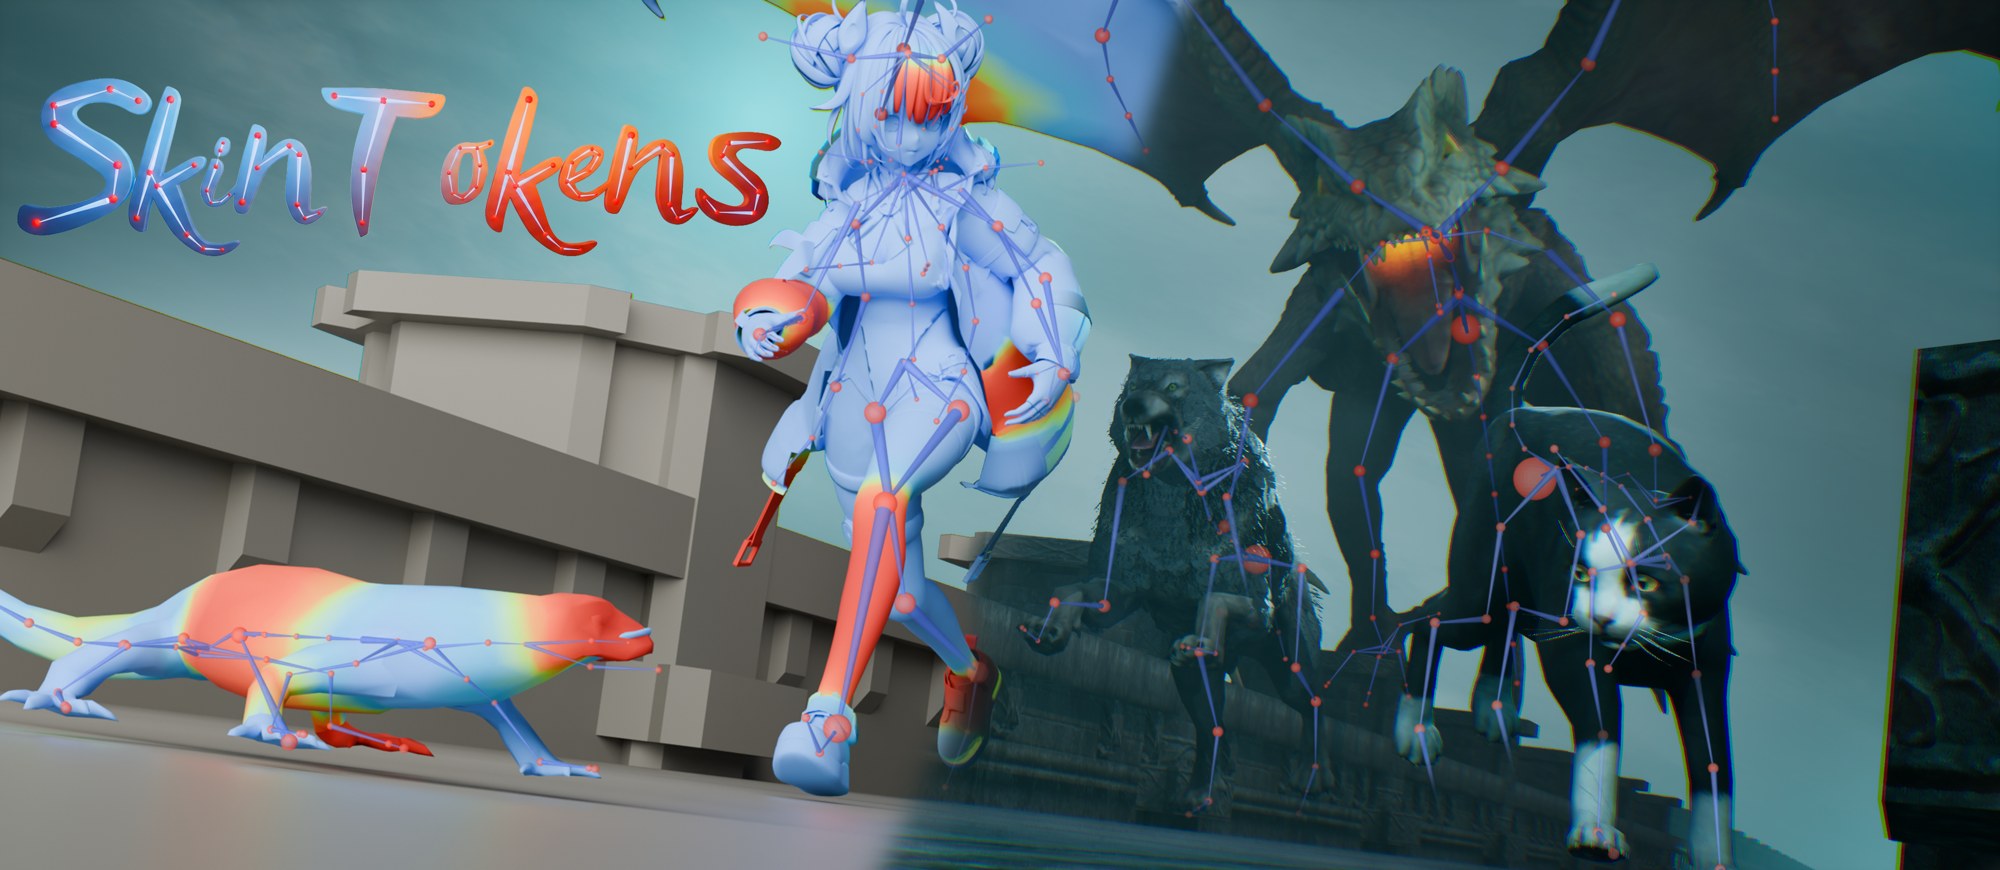
3Dモデルを入れると、スケルトンの階層とスキンウェイトをまとめて生成するオートリギングの研究「SkinTokens」を紹介します。清華大学とVASTの研究チームによるもので、論文は2026年2月にarXivで公開され、推論コードと学習済みモデルもMITライセンスで公開されています。ブラウザで試せるデモもあります。
SkinTokensとは
SkinTokensは、スキンウェイトをコンパクトな「トークン」の並びに置き換える表現方法です。この表現を使ったリギングの仕組みが「TokenRig」で、メッシュを1つ入れると、骨の階層と頂点ごとのウェイトを1本の連続したシーケンスとして出力します。出力はそのまま一般的な3Dのパイプラインに持ち込め、キャラクターアニメーションやシミュレーションに使えるとしています。
VAST-AI-Researchが2025年のSIGGRAPHで発表した「UniRig」の後継にあたります。UniRigは骨の予測とスキニングを別々の段階で行っていましたが、SkinTokensは両方を1つのシーケンスにまとめました。既存手法と比べて、スキニングの精度が98〜133%、骨の予測が17〜22%向上したとしています。
ウェイトを「塗る」のではなく「単語として並べる」
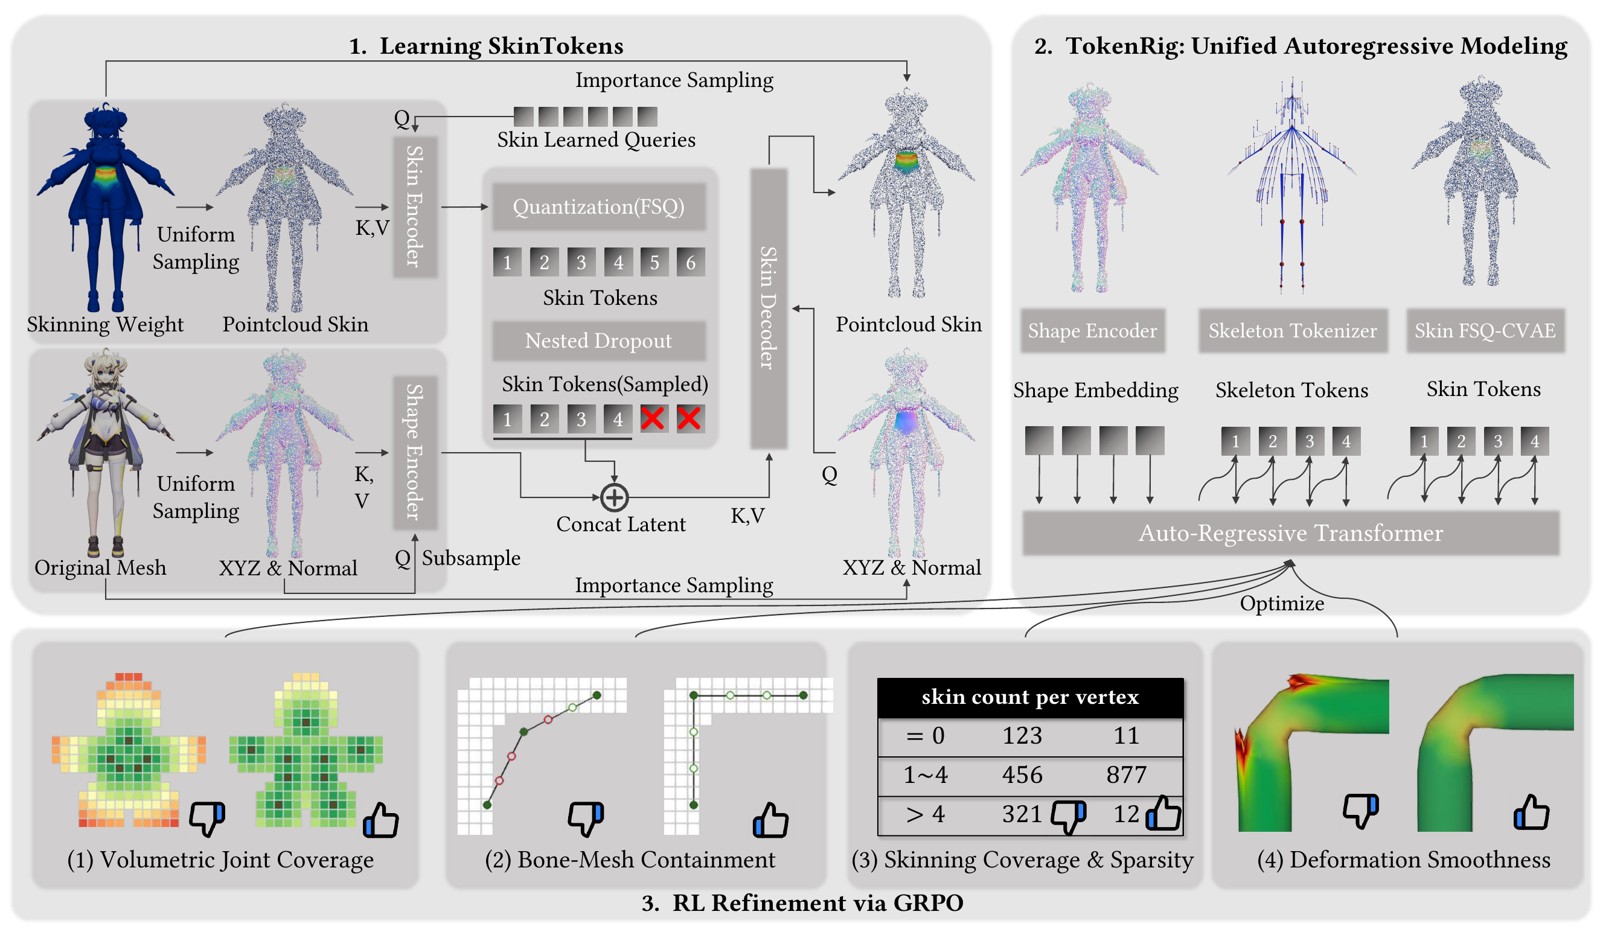
これまでの自動スキニングは、全頂点×全ボーンの重みを一度に数値で当てにいく回帰の問題として扱われてきました。研究チームは、ウェイトが実際にはごく一部のボーンからしか影響を受けていない(疎である)点に着目し、これを表現の問題として捉え直しています。仕組みは3段階です。
- SkinTokensの学習:FSQ-CVAEで、疎なスキンウェイトを離散的な語彙(トークン)に圧縮する
- 自己回帰での一括生成:Qwen3-0.6BをベースにしたTransformerが、スケルトンに続けてSkinTokensを1本のシーケンスとして生成する
- 強化学習での仕上げ:GRPOで、関節が体積の中に収まっているか、ボーンがメッシュからはみ出していないか、ウェイトが疎か、変形がなめらかか、を報酬にして学習にない形のモデルへの対応力を上げる
離れたパーツにウェイトがにじみにくい
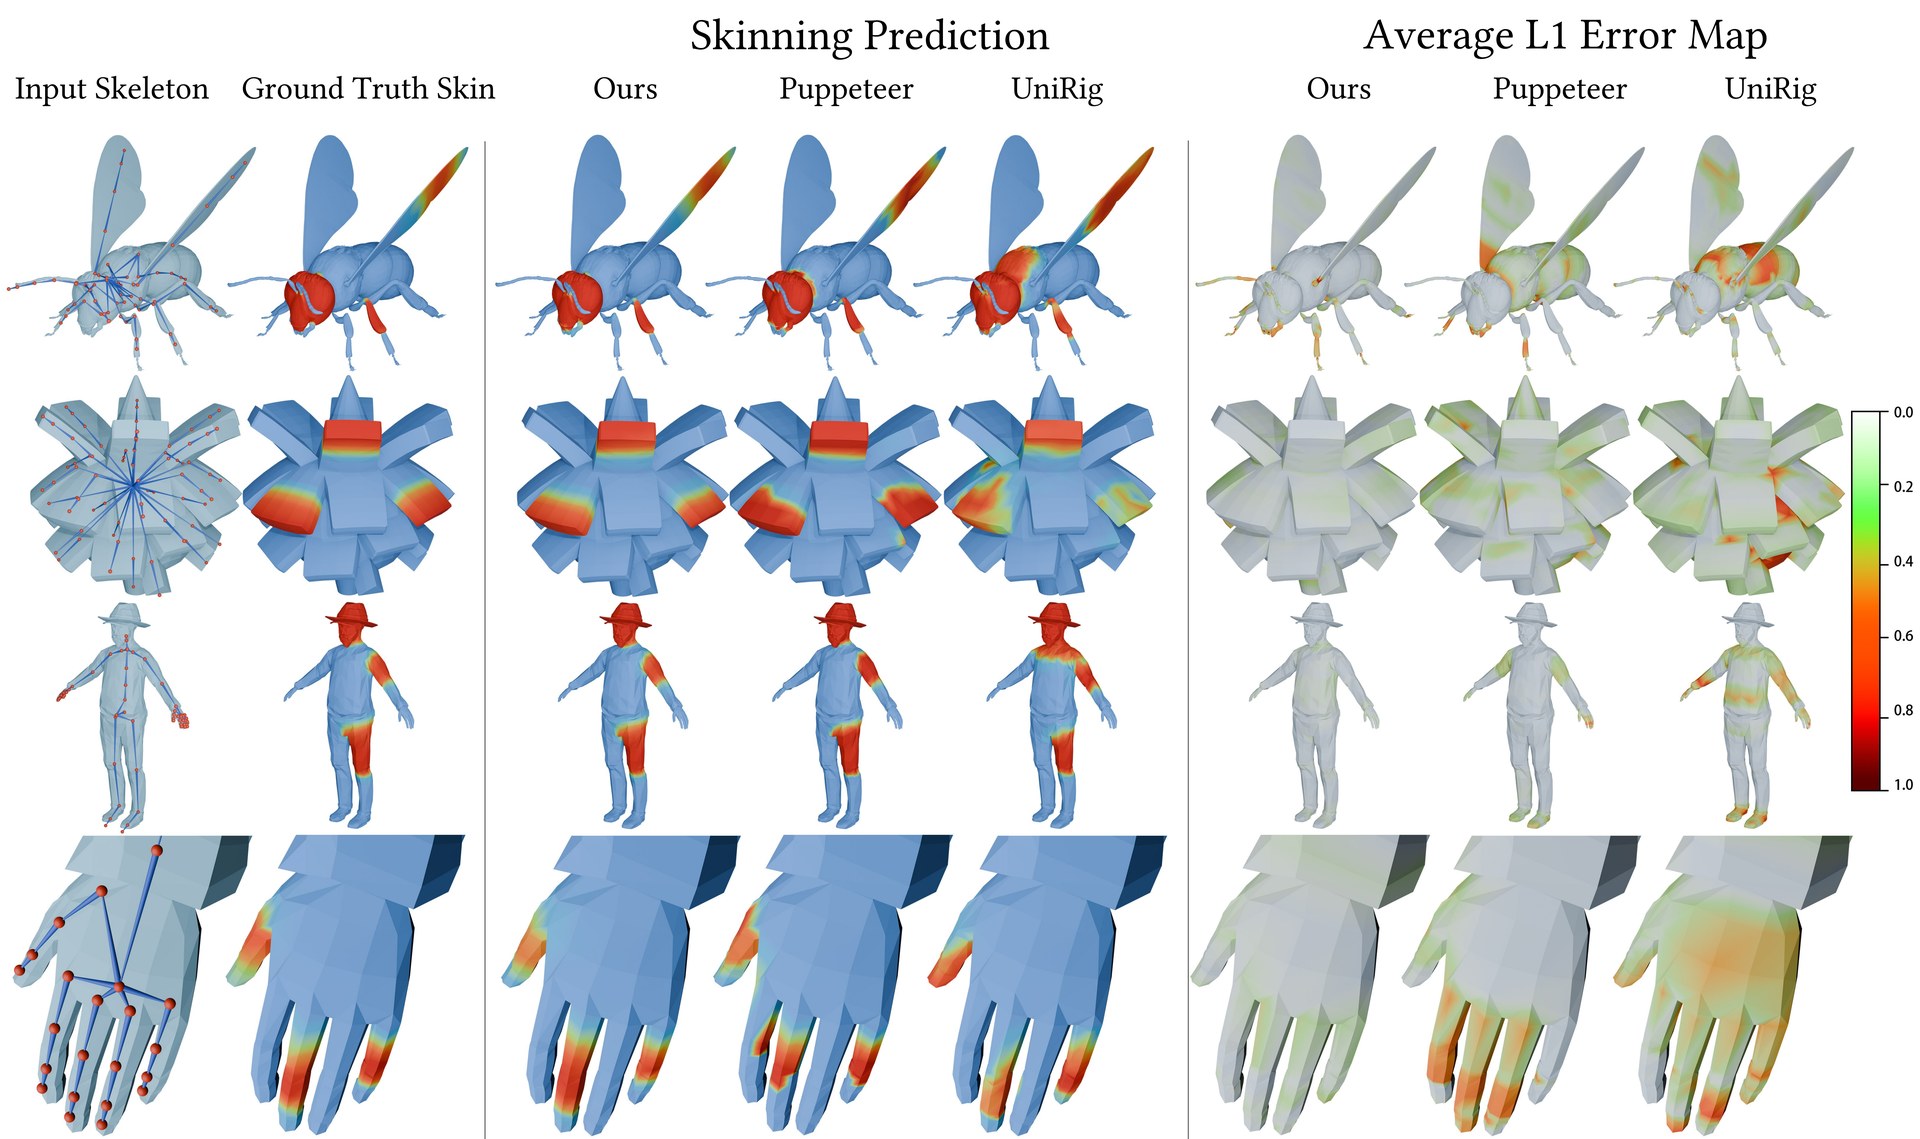
スキニングの比較では、同じスケルトンを入力として、Puppeteer・UniRigと結果を並べています。既存手法では、つながっていない別のパーツにまでウェイトがにじむ「ブリーディング」が起きやすいのに対し、TokenRigは正解のウェイトに近い、局所的にまとまった影響範囲になっているとしています。指の比較では、隣の指への漏れの差が誤差マップで見えます。
4足歩行やクリーチャーにも骨を入れる
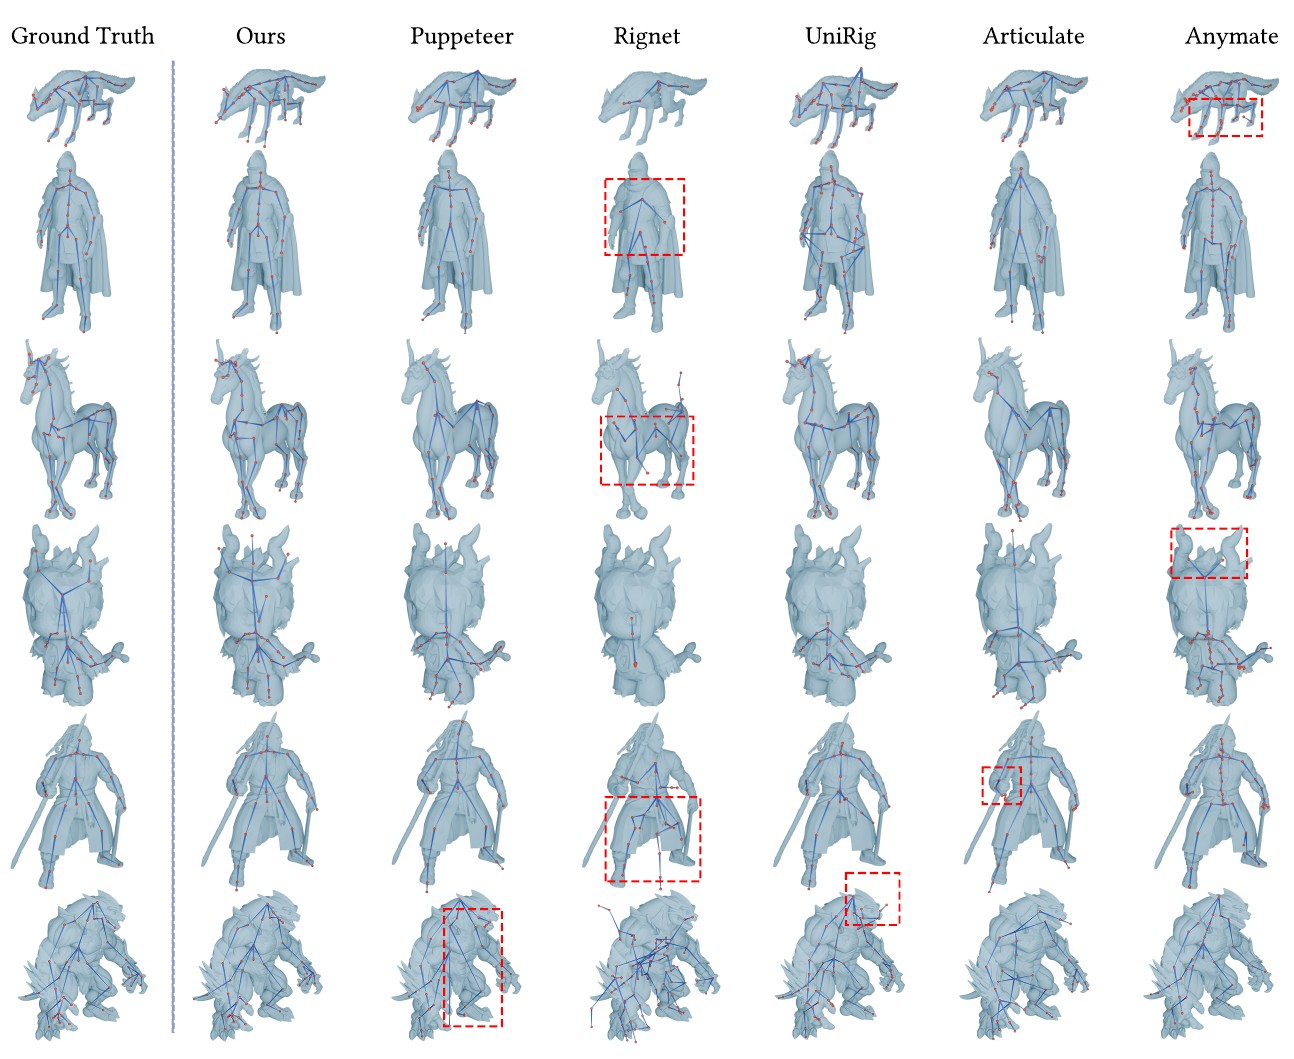
骨の生成の比較では、オオカミ、マントを着た人物、ユニコーン、デフォルメキャラクター、剣士、クリーチャーの6体で、Puppeteer・RigNet・UniRig・Articulate・Anymateと並べています。学習データはArticulationXL 2.0、VRoid Hub、ModelsResourceで、アニメ調のキャラクターから4足の動物、ファンタジーのクリーチャーまでを対象にしています。
試し方と動作条件
ローカルの環境を用意しなくても、Hugging Faceのデモにメッシュを上げればブラウザでリグ付きの結果が返ってきます。手元で動かす場合は、推論にVRAM 14GB以上のNVIDIA GPUが必要です。既存のスケルトンを使ってスキンウェイトだけを生成するモードや、元のテクスチャとスケールを引き継ぐオプションもあります。
READMEには、結果をBlenderに読み込んだときに「glTF_not_exported」ノードを消すようにという注意も書かれています。
価格・入手先
| 価格 | 無料 |
| ライセンス | MIT |
| 作者 | Jia-Peng Zhang ほか(清華大学・VAST) |
| 入手先 | GitHub / Hugging Face(デモ) |
手元での実行にはPython 3.11以上、CUDA 12.1以上、flash-attnが必要です。セットアップ手順と生成パラメータはGitHubのREADME、比較の全体と紹介動画はプロジェクトページ、論文はarXivにあります。
管理人のひとこと
リグの仕事で時間を食うのは、骨を入れるところよりウェイトの詰めのほうで、特に指や髪の房のように隣り合ったパーツの漏れを1本ずつ消していく作業です。比較の図で真っ先に目が行ったのも、指の誤差マップでした。
既存のスケルトンを渡してウェイトだけ出させるモードがあるので、社内のリグ規格に骨を合わせたまま、最初の塗りだけ任せる使い方ならできそうです。そこから先の詰めは結局手作業になると思いますが、出発点がどのくらい正解に近いかで、残りの手間がだいぶ変わりますね。
コメント