NVIDIAをはじめとする研究機関のチームが、複数枚の写真から高品質な3Dシーンを自動で再構築する革新的な技術「ArtiFixer」を発表しました。SIGGRAPH 2026で公開されたこの技術は、写真だけでは捉えきれない空間を補完し、よりリアルで完成度の高い3Dシーンの生成を目指します。
ArtiFixerとは
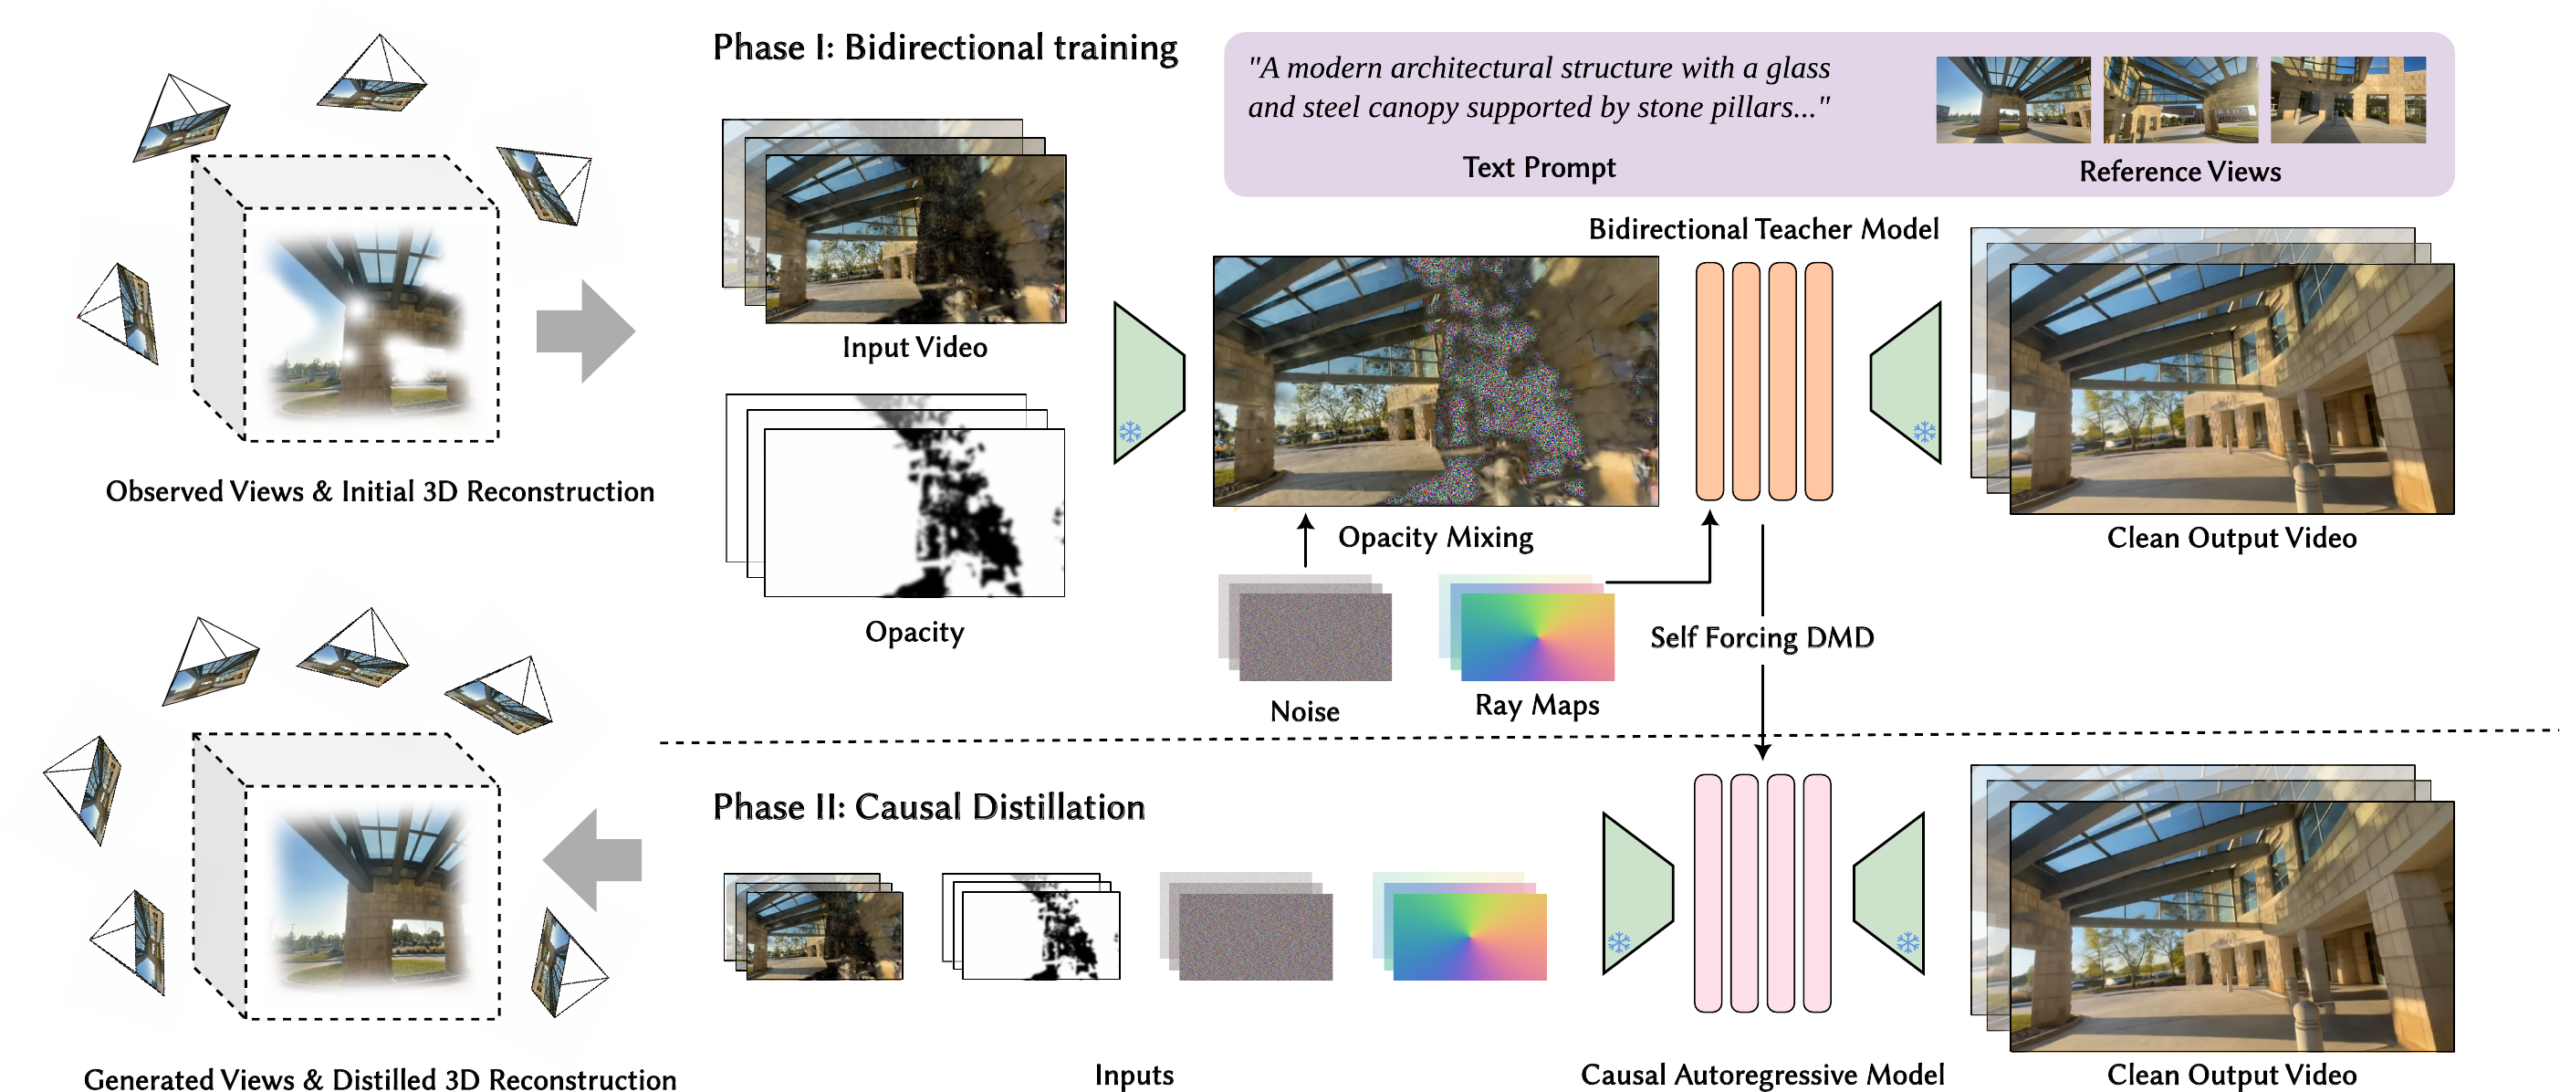
ArtiFixerは、自動回帰型ディフュージョンモデルを活用することで、限られた視点からの写真データのみでも、未観測領域の空間を自然に補完しながら3Dシーンを生成する技術です。従来の3D再構築手法が苦手としていた、観測が不十分な領域におけるアーティファクト(不自然な歪みや欠落)の生成や、既存のシーン情報との不整合といった課題を解決します。
主な特徴
- 2段階のパイプラインによる高精度な再構築: まず、オパシティミキシング戦略を取り入れた双方向生成モデルを訓練し、既存の観測データとの一貫性を保ちつつ、未知の領域の生成能力を維持します。次に、このモデルを因果的自動回帰モデルに蒸留することで、一度に数百フレームの生成を可能にし、効率的な3Dシーン生成を実現します。
- 観測データとの高い一貫性: 入力されたRGB画像とレンダリングされたオパシティマップをガウスノイズと混合することで、モデルは既存のシーン内容との一貫性を維持しやすくなります。これにより、不自然な生成を防ぎ、より現実に近い3Dシーンを構築します。
- 未観測領域への高い対応力: 空間補完能力に優れており、写真だけでは情報が不足しがちな領域も、自然な形で生成・拡張することができます。
- 既存手法を凌駕する品質: MipNeRF 360データセットを用いた評価では、既存の最先端手法と比較してPSNRで1〜3dB上回る結果を示しており、特に既存手法が全く機能しないような複雑なシナリオにおいても、より自然で説得力のある再構築を可能にします。
アニメ・CG制作での活用
このArtiFixer技術は、特に背景モデリングや環境アセット制作において大きな可能性を秘めていると考えられます。例えば、実写のロケハン映像や写真から、アニメやゲームで必要とされる精緻な3D背景モデルを効率的に生成・補完する際に役立つでしょう。キャラクターが動き回る空間を、限られた写真素材からでも高品質に構築できるため、シーン全体のリアリティ向上に貢献することが期待できます。また、CG制作におけるワークフローの高速化や、手作業では困難な部分の自動化にも繋がる可能性があります。
詳しくはresearch.nvidia.comをご覧ください。
管理人のひとこと
SIGGRAPH 2026で発表されたという、このArtiFixerには正直ワクワクさせられますね。私自身、アニメの背景モデラーとして、現地での写真撮影や資料集めは欠かせない作業ですが、どうしても情報が足りない場所や、撮影が難しいアングルが出てきてしまうんです。そういった部分をAIが自動で、しかも自然に補完してくれるというのは、まさに夢のような話だと感じます。特に、既存のシーンとの整合性を保ちながら未観測領域を生成するという点が、単なる画像生成AIとは一線を画す部分なのではないでしょうか。まだ論文段階で、実際に使えるようになるまでには時間がかかるかもしれませんが、将来的にこれが実用化されれば、背景制作の工程が劇的に変わる可能性を秘めていると感じました。現時点では、私の普段使っている3ds MaxやBlenderで直接使えるようなプラグインの登場を期待したいところです。
コメント