World Labsが2026年9月1日、新しいワールドモデル「Atlas」を発表しました。テキスト・画像・映像・3Dを1つのモデルで扱い、参照画像を1〜6枚渡してカメラの動きを指定すると、最長1分・1440pの映像を生成します。現在は選ばれたパートナー向けのアーリーアクセス段階です。
Atlasができること
World Labsはワールドモデルを「世界を生成し、再構成し、シミュレートするもの」と説明しています。Atlasはテキスト・画像・カメラの位置姿勢・3Dの深度マップをはじめから扱えるように一から事前学習された「オムニモデル」で、すべての入力を1つの共有された空間コンテキストにまとめて、その続きを生成する仕組みです。公式ページでは、できることが4つに整理されています。
- カメラ制御つきの生成: 1枚以上の画像から、任意のカメラ位置・角度の映像を生成
- 空間の再構成: 1枚から数十枚の画像で実在の場所を復元
- 時空間のシミュレーション: 映像の別アングルへの組み直しと、ロボット向けReal-to-Sim
- 画像生成: テキストからの画像と360度パノラマ
カメラを座標で指定できる
Atlasはカメラの正確な形状情報をモデルが直接受け取る入力として扱います。World Labsは、これがテキストによる大雑把な指示によるカメラ制御を超える点だとしています。参照画像の内容と形状に合った新しいアングルを生成し、写っていない部分はモデルが持つ世界の知識から補完します。公式ページの例では、1枚の入力画像からロボットの背面や、プールの隣にあるはずの芝生を推測して描き出しています。
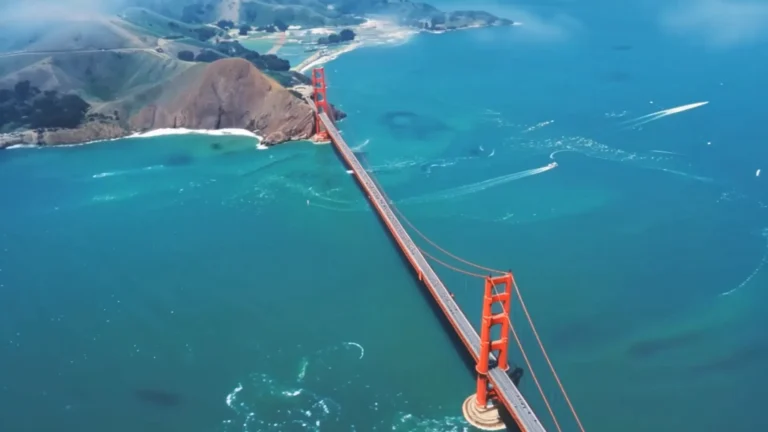
カメラの移動と空間コンテキストの管理を組み合わせると、長い映像も制御しながら作れます。公式ページには、少数の参照画像と手で設計したカメラパスから1分・1440pの映像を生成した例が置かれています。World Labsはこれを「スロットマシンのレバーを引くのではなく、シーンを組んでいる」「監督の椅子に座る」と表現しています。
2枚か3枚あれば実在の場所を再構成できる
空間の再構成では、特別な撮影機材も何百枚もの密な視点も要らないとしています。入力の視点に写っていない部分はモデルが埋めますが、画像を増やすほど想像で補う量は減る、という関係です。公式ページでは「2〜3枚でも忠実な再構成が得られ、3D再構成だけを学習した専用モデルの最高水準を上回る」としたうえで、100枚を超える入力も空間コンテキストに入れられると書かれています。
例として、地上で撮った1枚の写真から上空からの俯瞰を生成し、2枚目・3枚目と足すにつれて庭・隣の家・母屋が順に正確になっていく過程が示されています。スタンフォード大学のメインクアッドを2〜25枚の地上写真から組み上げ、キャンパス上空を飛ぶカメラパスを生成した例もあります。同じシーンに対して速度や長さの違う複数のカメラパスを作っても、シーンの内容は一貫したままだとしています。
点群と3Dガウシアンスプラットで書き出せる
出力は2Dの画像と映像だけではありません。Atlasは画像フレームと3Dの深度マップの両方をそのまま扱うため、点群や3Dガウシアンスプラットとして世界を出力できます。1枚の入力画像からは、新しい視点の生成と形状の推定を同時に行って3Dの世界を作ります。実在の空間を撮った映像からは、全フレームの深度を予測してまとめ、3D再構成にします。どちらの場合も、カメラが一度も見ていない領域はモデルが埋めます。
点群はシーンの形状を推定したものですが、そのままでは使いにくいため、残った隙間を埋めて3Dガウシアンスプラットのシーンに変換します。これは同社の既存製品Marbleと同じ表現形式で、Atlasは今後のMarbleや他の製品にも使われる予定とされています。
スマホ3〜5台でバレットタイムを組める
時空間のシミュレーションでは、Atlasが空間の構造と時間経過の両方を理解している点を使います。映像の組み直しでは、3台程度のカメラの映像があれば時間を止めて別アングルから見せられる、いわゆるバレットタイムのような撮影ができるとしています。公式ページの作例は、専門の撮影者も専用機材も使わず、エンジニアと研究者がバックパックに入る三脚とクランプで市販のスマートフォンやアクションカメラを固定して撮ったもので、3〜5視点から再構成しています。
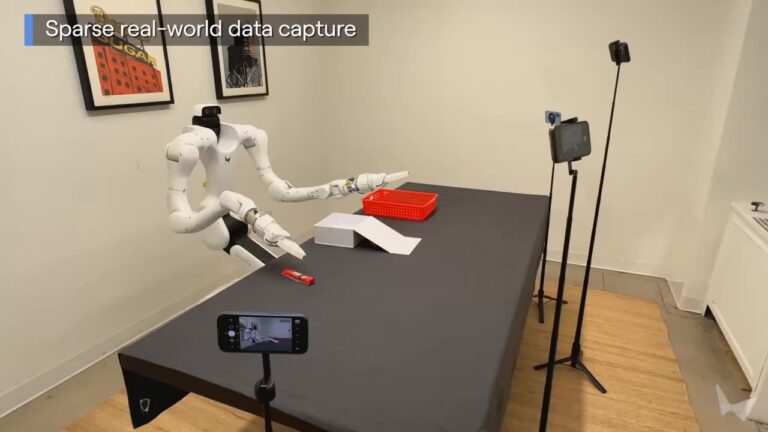
ロボティクス側では、再構成した空間の中をロボットが移動したときに、そのセンサーが見るはずのRGBと深度もAtlasが生成します。World Labsは、スマートフォンで撮影した2つの大きな環境を、それぞれ24フレームだけ使って再構成したと書いています。物体の動きや相互作用まで含めてシミュレーションを組めば、物体・位置・ロボットの動き・照明・背景を差し替えて学習データを量産できる、という説明です。
ベンチマークの結果
World Labsは、Atlasが多くのタスクをこなすオムニモデルであるため、その汎用性を1つの指標で測ることはできないとしたうえで、カメラ条件つき生成と3D再構成の2つで定量評価を出しています。
カメラ条件つき生成では、1枚の入力画像と1〜3個の映画的なカメラモーション(パン、トラック、クレーンなど)を組み合わせ、どちらが意図したカメラパスをよく追えているかを第三者の評価者が判定しました。Atlasが選ばれた割合は、MiniMax H3に対して75%、Gemini Omni Flashに対して81%、Happy Horse 1.1に対して86%、FLUX 3に対して93%、Seedance 2.5に対して94%です。なおAtlas以外のモデルはカメラを入力として受け取れないため、カメラパスは文章で指示しています。カメラの軌道が複雑になるほど差が広がったとしています。
疎な視点からの3D再構成では、平均絶対相対誤差(小さいほうが良い)でAtlasが25.3という値を示しています。比較対象にはPi3X、π³、VGGT-Ω 1B、Depth Anything 3、MapAnythingが挙げられており、World Labsは汎用モデルでありながら3D再構成に特化したオープンソースの最良モデルを上回ったとしています。
価格・入手先
Atlasは選ばれたパートナーとのアーリーアクセスに入った段階で、一般公開はされていません。
| 価格 | 記載なし(選ばれたパートナー向けのアーリーアクセス) |
| 作者 | World Labs |
| 入手先 | 公式ページのアクセス申請フォーム |
今後のMarbleをはじめとするWorld Labsの製品にもAtlasが使われる予定とされています。
発表と同時に、公式YouTubeチャンネルでも紹介映像が公開されています。
管理人のひとこと
ロボットの学習データを作る話が大きな比重を占めていて、うちの畑からはだいぶ遠いところにある発表です。それでも、カメラの位置と角度を数値で渡せるという一点は引っかかりました。生成物のカメラを文章で指示するのは、こちらが持っているコンテのアングルを言葉に翻訳する作業になるので、そこが座標で済むなら話が変わってきます。
もう1つ気になったのは、スマホ3〜5台を三脚で立てただけの収録から別アングルを起こしている作例です。ロケハンの写真から背景のあたりを起こしたい、くらいの用途だと現実的な機材の量に見えます。実際にどこまで形が信用できるものなのかは、触れるようになってからでないと分かりませんが。
コメント